IA · Infraestrutura · Opinião
Você não pode culpar o ChatGPT num post-mortem
O papel da inteligência artificial na engenharia de infraestrutura e a importância do conhecimento técnico.
A inteligência artificial já participa de todas as etapas do desenvolvimento de software: escreve código, gera testes, revisa pull requests e até ajuda a operar sistemas em produção. Usada do jeito certo, ela poupa horas de trabalho. Mas, quando o projeto envolve infraestrutura crítica, a margem para erro é bem menor.
Um código mal feito costuma cobrar um preço gradual: tempo de resposta maior, complexidade crescendo, dívida técnica acumulando. É ruim, mas geralmente localizado. Um erro na infraestrutura é outra história. Uma permissão errada, uma política mal escrita ou um comando executado sem revisão podem derrubar um serviço inteiro de uma vez, com impacto direto nos clientes e no financeiro.
A responsabilidade por uma decisão equivocada ou por uma alucinação do modelo fica com quem a aceitou.
Modelos de inteligência artificial podem até projetar e implementar arquiteturas e servidores, mas não podem ser responsabilizados caso algo dê errado. Na prática, a responsabilidade por uma decisão equivocada ou por uma alucinação do modelo fica com quem a aceitou, não com OpenAI, Anthropic, Google ou as demais. Por isso, por trás de qualquer IA precisa existir um profissional competente, que entenda o que está sendo feito.
Como a IA deixa tudo mais fácil e rápido, não é incomum ver bons profissionais cedendo à tentação de aceitar sugestões e implementações sem revisar direito. Afinal, a IA geralmente acerta. Geralmente. Mas e quando o inesperado acontece? E quando o modelo não compreende todo o contexto da aplicação e mexe em algo que não deveria? E quando comete um erro grave? Nesse momento, quem não entende o que foi feito pode transformar um incidente de gravidade média em uma catástrofe.
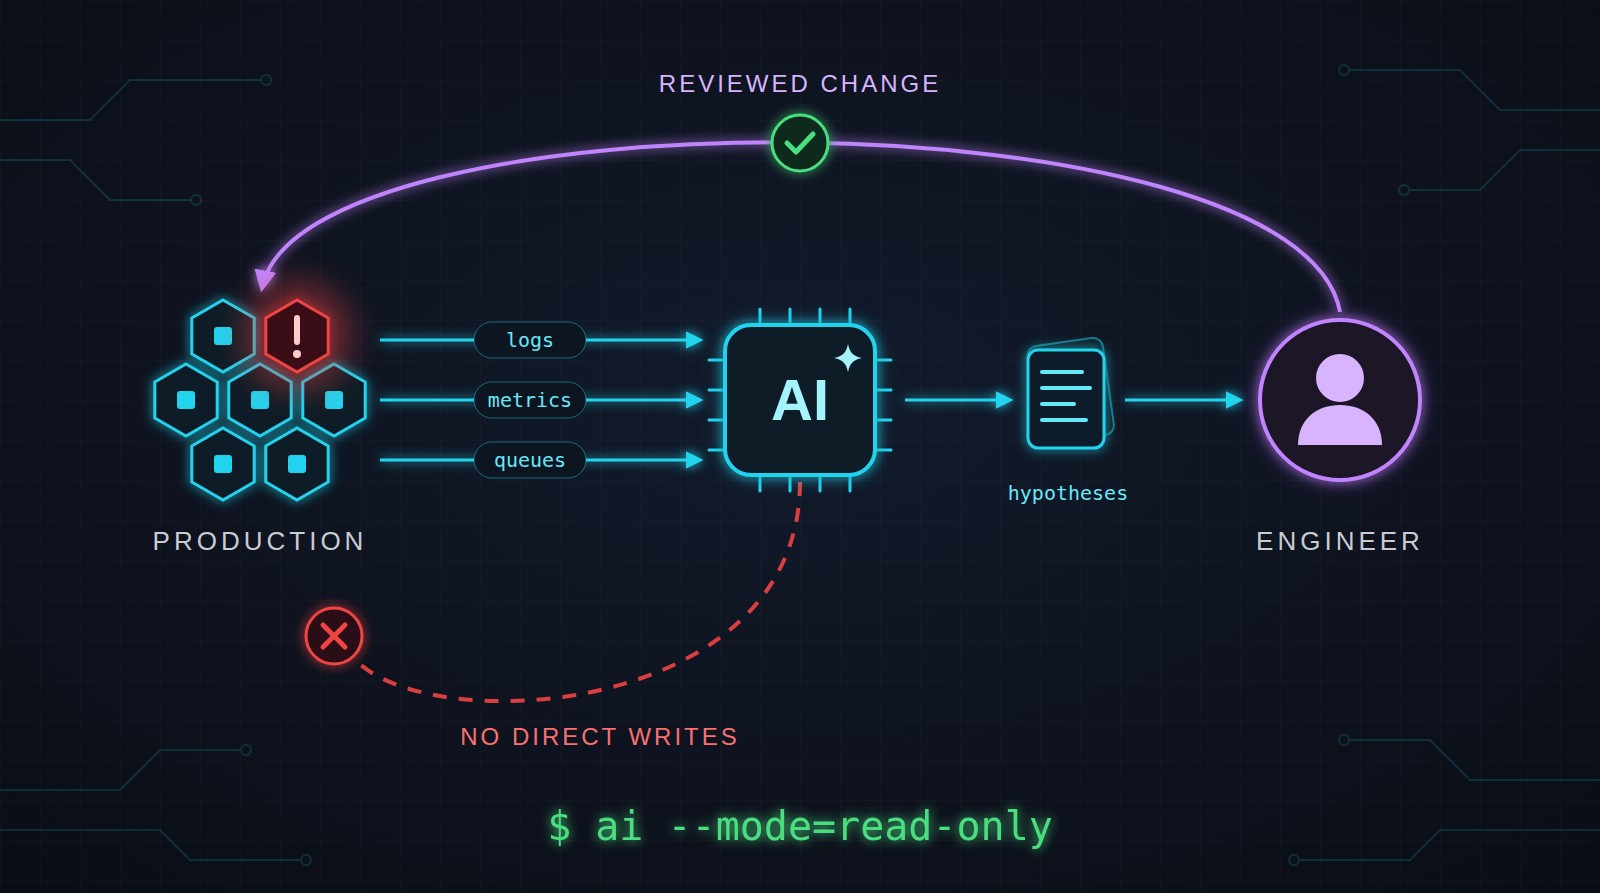
No meu dia a dia, uso IA com muita frequência, e ela me poupa horas de trabalho. Hoje me ajuda a montar dashboards de observabilidade, a ler e extrair informações de grandes volumes de logs, a analisar erros e a escrever post-mortems. Num incidente, por exemplo, preciso cruzar logs de aplicações, banco de dados e filas para entender o que aconteceu e em que ordem. Fazer isso “à moda antiga” levaria horas, às vezes dias, de leitura e correlação manual. Hoje, com um agente organizando e resumindo esses dados, chego às primeiras hipóteses em poucas horas e uso meu tempo no que realmente importa: decidir qual delas faz sentido e o que fazer a respeito.
É nessa divisão que está o ganho real. A IA é muito boa em processar volume: ler milhares de linhas de log, encontrar padrões, montar a primeira versão de um dashboard ou de uma linha do tempo de incidente. Mas ela não sabe o que é normal no meu ambiente, quais serviços são críticos nem o que mudou na semana passada. Esse contexto é meu, e é ele que separa uma hipótese plausível da causa verdadeira.
O que a IA faz bem
- Ler milhares de linhas de log
- Encontrar padrões
- Montar a primeira versão de um dashboard ou de uma linha do tempo de incidente
O contexto que é meu
- O que é ruído e o que é sinal nos meus alertas
- O impacto de cada serviço no negócio
- O que não está documentado em lugar nenhum
A IA também me ajuda a pensar em arquitetura. Descrevo o problema e ela traz ideias, alternativas e caminhos que eu talvez não considerasse de primeira. Quando preciso executar algo na AWS, ela me dá os comandos exatos, e não preciso mais ficar abrindo a documentação a cada passo. Ela também é boa para pesar uma decisão: pedir os pontos positivos e negativos de uma ideia ajuda a enxergar riscos e custos antes de começar. Mas quem decide sou eu. Leio cada comando que ela sugere antes de rodar, confiro o que ele faz, em qual recurso e o que acontece se der errado, e reviso tudo com cuidado. Minha regra é simples: a IA pode ler, mas não pode alterar. Ela consulta logs, métricas e configurações à vontade, e é isso que torna um agente tão útil num incidente. Mas qualquer coisa que mude o ambiente, como aplicar uma política, alterar um recurso ou fazer um deploy, passa por mim antes, porque basta um comando perigoso ou mal pensado para virar um problema em produção.
No último ano à frente de uma infraestrutura de produção, encontrei erros nas sugestões dos modelos mais avançados diversas vezes. Em alguns casos a ideia era boa, mas não se aplicava ao contexto da aplicação e causaria problemas se fosse implementada do jeito que o modelo projetou. Em outros, ele alucinou: afirmou algo que eu percebi estar errado e, quando questionei, corrigiu-se.
Uma IA que cedeu à sua insistência não confirmou que você está certo.
Mas repare no que aconteceu: o modelo só se corrigiu porque eu questionei, e eu só questionei porque sabia que a resposta estava errada. O problema é que ele teria cedido do mesmo jeito se o errado fosse eu. A maioria dos modelos tende a concordar com quem está conversando: se você contesta uma resposta, mesmo com argumentos falhos, o modelo costuma reavaliar o que disse e ceder, estando você certo ou não. Isso torna muito fácil “dobrar” a IA até ela concordar com o seu ponto de vista.
Aí está o risco: você insiste até o modelo validar uma ideia que já queria ver aprovada, e essa validação passa a parecer uma segunda opinião técnica, quando na verdade é o seu próprio viés de confirmação voltando para você. Fica pior quando isso vira argumento. “A IA concordou comigo” é usado para defender uma proposta numa discussão técnica, e uma ideia fraca ganha ares de ideia validada. Uma IA que cedeu à sua insistência não confirmou que você está certo. E, se a decisão der errado, “a IA concordou comigo” não vai entrar no post-mortem como causa raiz.
No fim das contas, nada substitui o conhecimento técnico adquirido com estudo e experiência. A IA é uma ferramenta poderosíssima, que veio para ficar e está mudando a forma como desenvolvemos software, mas acredito que seja crucial mantermos o hábito de estudar e de entender o que fazemos, mesmo quando a IA poderia fazer por nós. É esse conhecimento que me permite perceber quando uma sugestão não se aplica ao meu contexto, quando o modelo alucinou e quando estou só tentando fazer com que ele concorde comigo. Sem ele, eu nem saberia que a resposta estava errada.
No fim de 2021, o público em geral não fazia ideia do que era um LLM. O ChatGPT ainda não existia, e o GPT-3, acessível apenas por API, estava muito aquém dos modelos atuais. Hoje eles trabalham com contextos de milhões de tokens, projetam sistemas e escrevem, revisam e testam código em um nível que impressiona até profissionais experientes. Em 2031, os modelos serão melhores e provavelmente errarão menos. Ainda assim, quando algo der errado em produção, alguém vai precisar explicar o que aconteceu, por que foi feito e como corrigir. Essa pessoa será um profissional valioso, e eu quero continuar sendo um que entende o que está fazendo.